
上周有个做电商的朋友找我吐槽:花三百多块充了某绘图平台的会员,想给店铺生成几张”夏日清新风”主图,结果出来的图不是模特六根手指,就是背景里趴着一只莫名其妙的猫。他盯着屏幕问我:网上那些大神晒的图,跟我用的真是同一个东西吗?
这大概是每个刚接触AI绘画的人都会有的困惑——同一个工具,别人出图像电影海报,自己出图像恐怖片截图。差距不在运气,而在于很多人根本没搞明白:现在的AI绘画,早就不是2023年那个”抽卡碰运气”的年代了。
底层逻辑换了引擎:从”慢慢扩散”到”流匹配”
先说个很多人没意识到的事:今天主流模型的内核,已经不是当年Stable Diffusion那套经典扩散架构了。
有篇梳理2026年AI生图技术报告的解读提到一个关键趋势——混合架构正在崛起:用自回归模型负责”想清楚画什么”,用扩散/流匹配模型负责”把细节画好”。同时,十份前沿技术报告里有六份在用Qwen-VL系列做文本编码器,MM-DiT成为主流骨干,流匹配取代了传统扩散目标。看不懂这些名词没关系,你只需要记住翻译成人话的两点:
一是模型更听得懂人话了。以前你写一大段提示词,模型经常只抓住最显眼的几个词就开画;现在它对长提示词、空间关系的理解明显更强。实测对比里,FLUX.1-dev在生成”树皮纹理清晰、光斑透过树叶”这类描述时,裂纹和苔藓的质感明显比SD3更扎实(实测对比原文)。
二是出图快了好几倍。蒸馏技术已经是行业标配:Seedream 3.0用轨迹蒸馏做到4-8倍加速,Z-Image的Turbo版8步就能出图,以前动辄三四十步的等待,现在几秒到十几秒就搞定。这也是为什么各家纷纷换流匹配路线——不只是质量更好,还更容易压缩提速。
参数规模上的差距也很直接:SD3最高约80亿参数,而FLUX.1直接堆到120亿,单个模型文件就有23GB。家底厚,画面细节、手部结构、文字渲染这些老毛病自然改善明显——FLUX现在只要提示词写得准,能直接输出带可读文字的海报级图片(FLUX对比解析)。
工具怎么选:别问哪个最强,问你要干什么
新手最常问”Midjourney和Stable Diffusion哪个好”,这个问题本身就问错了。2026年的正确姿势是按场景组合使用:
- Midjourney V7出主视觉,艺术性和照片级真实感是它的强项,做氛围图、概念图很香;
- FLUX / SD系做定制和精修,开源生态意味着你能用ControlNet控制构图、用LoRA锁定风格、用Inpainting局部重绘;
- 文字多的海报,直接上Ideogram或FLUX,传统模型在这块还是容易翻车。
想本地部署的话,硬件门槛也得心里有数(部署配置参考):
| 级别 | 显卡要求 | 大概速度 |
|---|---|---|
| 入门 | 8GB显存(RTX 3060) | 约30秒/张 |
| 主流 | 12GB显存(RTX 4070级) | 约15秒/张 |
| 专业 | 24GB显存(RTX 4090) | 约5秒/张 |
不想折腾硬件,Replicate、SeaArt这类云端平台按次计费也行,先去试再买。
专业玩家这边,ComfyUI已经成了事实标准——节点式工作流把采样器、LoRA、ControlNet的每一步都可视化,搭好一次流水线就能批量复用。界面看着吓人,其实逻辑跟搭乐高差不多:
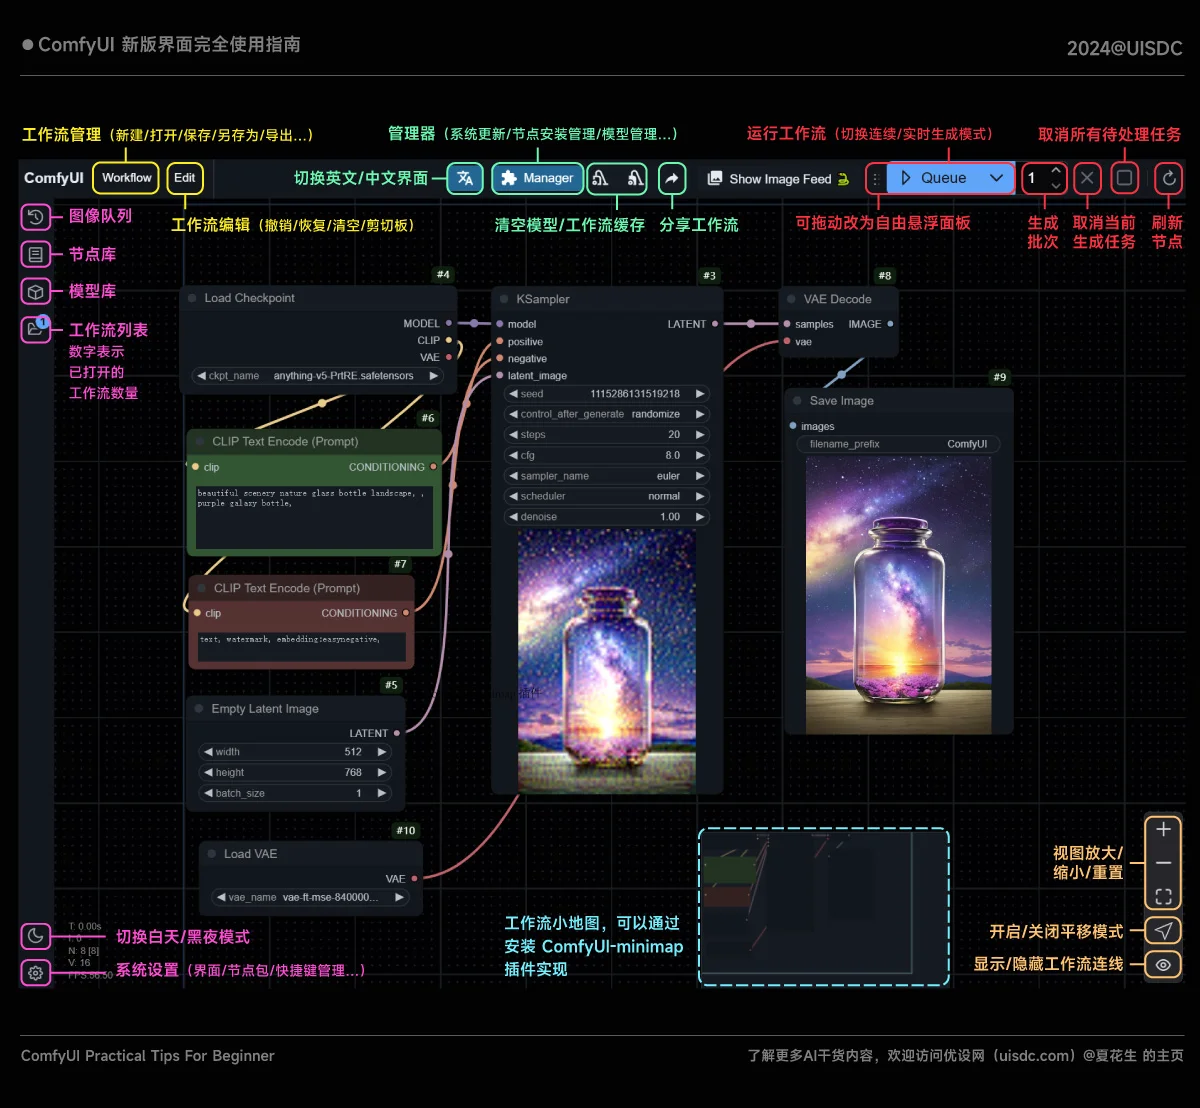

(上面这张就是最简单的文生图流程:加载模型→文本编码→采样→解码→保存,摸清这一条线,剩下的都是在这条线上加零件。)
提示词不是咒语,是写给画师的brief
回到开头那位朋友的翻车现场。我看了一眼他的提示词:”夏天,好看的女孩,清新背景。”——就这?你找真人画师接单,只丢一句”画得好看点”,对方估计想顺着网线过来打你。
提示词的正确写法是结构化描述:主体是谁、在什么环境、什么光线、什么构图、什么风格,一项一项交代清楚。一个实用模板是:
主体 + 动作/状态 + 环境 + 光线氛围 + 镜头/构图 + 风格 + 画质词
比如”穿白衬衫的女孩,站在傍晚的便利店门口,暖色灯光,浅景深特写,日系胶片质感”。还有一点很多人不知道:FLUX这类新模型基本可以忽略负面提示词,正面描述写准了,单靠正面就能稳定输出,这跟老SD的玩法完全两码事。
再说两个容易踩的坑。一是中文长文字依旧不稳:简单标语可以,复杂排版还经常出现拼写错误和混乱字体,正式商用前一定要人工校对。二是多轮编辑会”悄悄变样”:技术压力测试发现,很多模型编辑时只”看上一帧”,对一张图连续改四五轮,第一轮的细节会静默退化——你让模型把猫放大再加只老鼠,几轮之后老鼠可能无声无息消失了(多轮编辑漂移问题)。所以重要素材,每轮编辑都留档,别嫌麻烦。
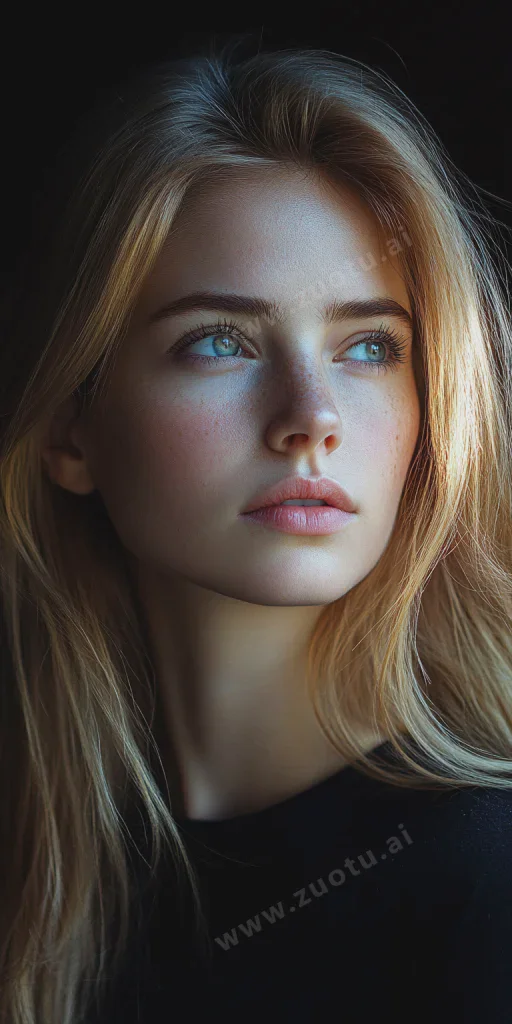
风格同质化也值得提一句。现在网上大量AI图都带着一股”算法光滑感”,皮肤完美到不像真人。艺术圈已经开始反着来,故意引导AI保留皮肤质感、数字噪点这些”不完美”,因为观众越来越能一眼认出假图。你要是做自媒体配图,适当追求粗糙真实感,反而更容易过读者的”AI雷达”。
从”所想即所得”到”所控即所得”
最后一个维度,说给真正想把AI绘画变成生产力的人听。
CVPR 2026上有一项叫ConsistCompose的研究,思路很直白:把坐标直接写进提示词里,比如”A cat [0.109, 0.297, 0.607, 0.870]“,模型就知道这只猫该待在画面的哪个区域,还能单独调节”布局约束的强度”而不影响画面内容(论文解读)。翻译过来:画什么和画在哪里,终于成了两个可以分开拧的旋钮。
这意味着海报设计、电商主图这类”版式有硬性要求”的场景,AI从玩具变成了工具。再配上垂直行业的LoRA微调——服装模型认得新中式盘扣和牛仔水洗工艺,建筑模型附带尺寸标注和采光分析——AI出的图正在从”好看的插画”变成”能直接交付生产的稿件”。业内把2026年叫”AI绘画商用元年”,不是没道理的(行业趋势分析)。
但商用之前,有件事必须泼盆冷水:版权。AI生成图的版权归属在多数司法辖区 still 是个灰色地带,拿来当商业素材前,务必确认所用平台的商用授权条款,重要项目留个生成记录,别等收到律师函才后悔。
写在最后
AI绘画这条路,我走了三年,最大的心得就一句话:它不会替代画师,但一定会替代”不会用AI的画师”和”瞎用AI的外行”。
工具进化得再快,翻车的原因永远是那两条:没搞懂工具现在的能力边界,也没学会把需求说清楚。你最近一次AI出图翻车是因为什么?评论区聊聊,说不定你踩的坑,正是下一篇文章的主题。